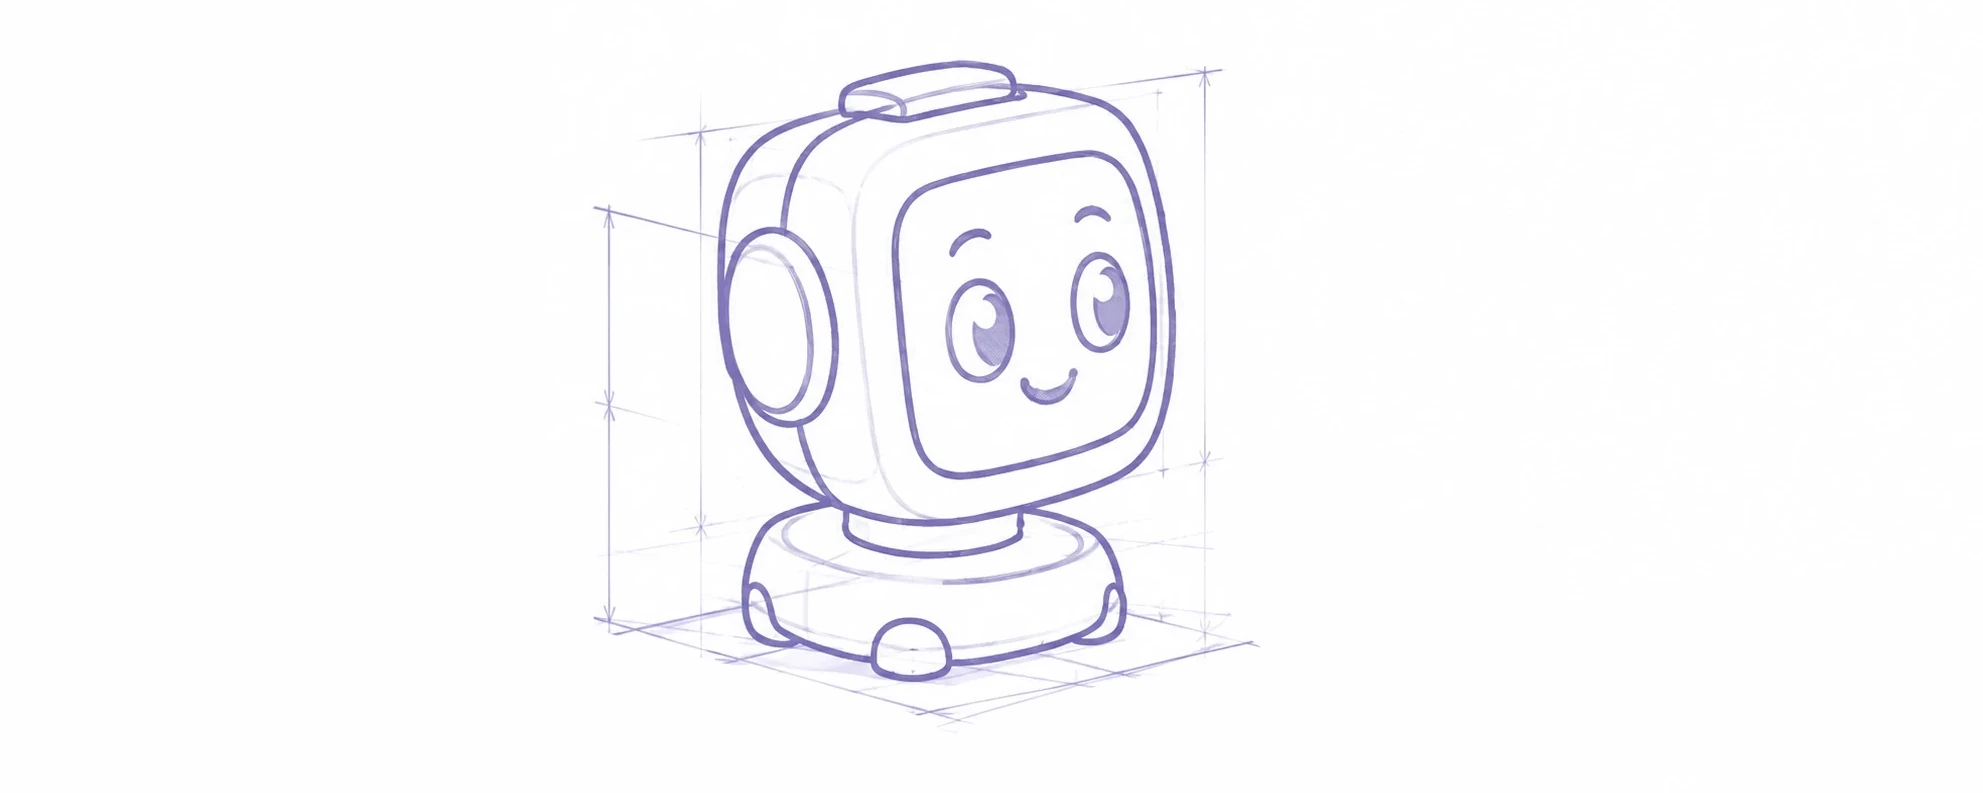
Dum-E : un deskpet entre électronique, robotique et logiciel embarqué
Avant de commencer, je me suis intéressé aux deskpets existants afin d'identifier ce qui m'attirait dans leur conception. Je voulais surtout mener un projet complet pour consolider mes connaissances en C++ et explorer de nouveaux domaines, notamment la robotique.
La page du projet Dum-E regroupe l'architecture générale ainsi que les différentes phases de développement.
Quelques projets inspirants
Avant de s'engager dans un développement aussi long, il est utile de s'inspirer de projets existants et de vérifier les approches déjà explorées. Le projet qui m'a le plus donné envie de me lancer est celui d'Ons Bahri, partagé sur LinkedIn :
https://www.linkedin.com/feed/update/urn:li:activity:7484932310392442881/
D'autres réalisations m'ont également intéressé, notamment le quadrupède de PetoiCamp et celui de PingguSoft. Ces deux projets se rapprochent davantage des quadrupèdes de Boston Dynamics.
L'idée d'interagir avec le robot, de voir différentes expressions faciales sur un écran LCD ou encore la possibilité de mettre à jour le système via OTA ont été les idées principales retenues pour composer Dum-E.
Architecture générale
L'objectif à long terme est de faire cohabiter plusieurs sous-systèmes sans que les contraintes d'un périphérique ne bloquent les autres. L'architecture repose donc sur un contrôleur de comportement central et sur des tâches propriétaires de leur matériel.
Phase 1 : créer un visage familier grâce à la vision 3D et aux expressions faciales
Un robot équipé de nombreux capteurs peut paraître intimidant. Je voulais donc le rendre sympathique dès le premier regard. Pour Dum-E, nommé en référence au robot assistant d'Iron Man, j'ai associé un capteur de proximité à un écran LCD afin d'obtenir une réaction immédiatement lisible.
La première version réunit les éléments suivants :
- un ESP32-S3, version N16R8, comme microcontrôleur
- un VL53L5CX pour détecter la présence et la position d'un objet devant le robot
- un GC9A01, écran LCD rond de 240 x 240 pixels, pour afficher les expressions du visage
Le premier objectif n'était pas encore de faire marcher le quadrupède, mais de valider une boucle complète de perception et d'expression :
- détecter un objet dans une zone du champ de vision
- déterminer sa direction principale et sa proximité
- transmettre une information compacte au cerveau du robot
- sélectionner un regard et une expression
- animer le visage sans bloquer les autres traitements
Le résultat attendu paraît simple : changer d'expression lorsqu'un objet est détecté. Il impose toutefois une certaine rigueur pour exploiter les mesures du ToF, zones de détection et oscillations autour des seuils, réaliser le rendu graphique, coordonner les tâches et maîtriser le coût mémoire.
Expressions faciales avec le module GC9A01
Première approche : une image par expression
Le GC9A01 a été choisi pour son format rond et sa simplicité d'utilisation. Il se connecte facilement à l'ESP32-S3 en SPI, ce qui permet un débit de transfert élevé. La première approche consistait à associer une image à chaque expression, comme ci-dessous.
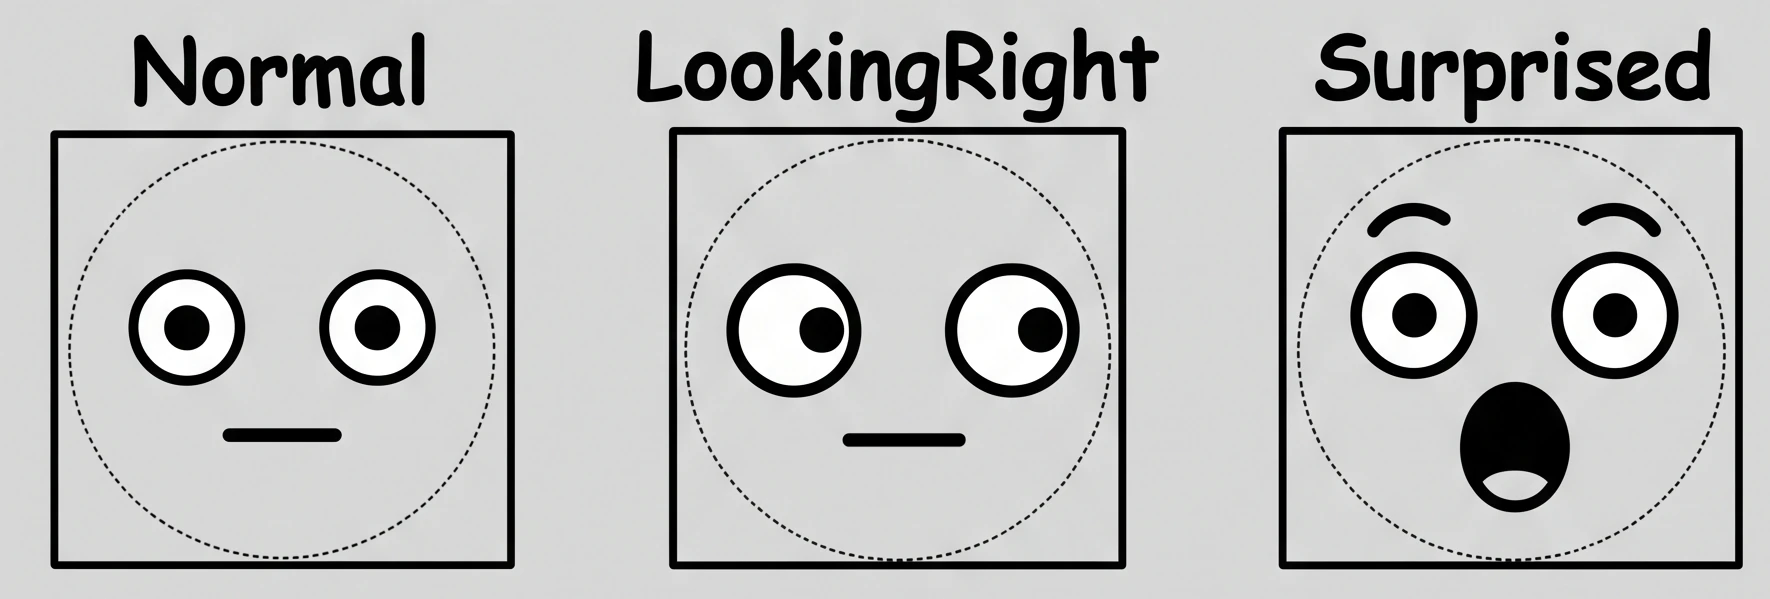
Après la configuration du bus SPI et les premiers essais d'affichage, deux problèmes sont apparus :
- les transitions entre les expressions sont trop directes : le changement brutal d'image ne rend pas les réactions du robot fluides
- les images d'expression nécessitent trop d'espace mémoire.
Deuxième approche : utiliser LVGL (Light and Versatile Graphics Library)
Pour créer des transitions entre les expressions, il ne suffit plus d'afficher une image par pose. Il faut décrire les éléments du visage puis transformer leurs propriétés pour passer progressivement d'une expression à l'autre. Les yeux, pupilles, sourcils, bouche et décorations (larme ou rougeur) par exemple sont regroupés dans une structure FacePose, puis dessinés avec les primitives de LVGL.
struct FacePose {
  EyePose eyes;
  PupilPose pupils;
  BrowPose brows;
  MouthPose mouth;
  std::array<DecorationPose> decorations;
};
LVGL est une bibliothèque graphique adaptée aux systèmes embarqués. Elle fournit des objets de dessin, une gestion des zones à rafraîchir et un mécanisme de temporisation, la tâche Display_thread est son unique contexte d'exécution. Elle permet ainsi de calculer les poses intermédiaires et d'envoyer à l'écran uniquement les bandes nécessaires, sans bloquer les tâches de perception ou de comportement.
À chaque demande d'expression, une fonction calcule l'interpolation depuis l'état réellement affiché vers la nouvelle pose. Il n'est donc pas nécessaire de définir une table de transitions pour chaque paire d'expressions, et de nouvelles expressions peuvent être ajoutées facilement. Neuf poses peuvent déjà évoluer librement, même si toutes les conditions de déclenchement ne sont pas encore implémentées.
Pour réduire davantage la mémoire utilisée par l'affichage LCD, le transfert SPI s'appuie sur le DMA. Seules deux bandes de 240 x 40 pixels sont allouées, puis transmises en six passes à 40 MHz pour mettre à jour l'écran.
| Stratégie | Mémoire | Allocation | Conséquence |
|---|---|---|---|
| Framebuffer RGB565 complet | 115 200 octets | Directe | Simple, mais coûteux en SRAM interne |
| Deux bandes de 240 x 40 pixels | 38 400 octets | DMA | Plus complexe, mais moins coûteux en SRAM interne |
La vidéo ci-dessous montre la transition des expressions et le déplacement du regard.
Détection de proximité avec le VL53L5CX
Le VL53L5CX est un capteur de profondeur multizone capable de mesurer jusqu'à 8 x 8 zones. Sa bibliothèque est compatible avec l'ESP32-S3. La configuration actuelle utilise une grille de 4 x 4 zones à 4 Hz afin de ne pas surcharger le système avec des données qui peuvent être traitées toutes les 250 ms. Seize cellules suffisent pour valider la classification directionnelle tout en réduisant le volume de données et le coût de traitement.
Après son initialisation et sa configuration, le capteur fonctionne sur interruption et peut signaler au système qu'une nouvelle mesure est disponible. Un réveil supplémentaire toutes les 100 ms évite toutefois de dépendre entièrement de cette interruption : après chaque réveil, la tâche vérifie explicitement si des données doivent être analysées.
Du champ de profondeur au déplacement des pupilles
Le suivi s'effectue actuellement de manière plus simple qu'avec un barycentre continu. Les seize zones sont regroupées en huit secteurs directionnels, auxquels s'ajoute le centre. La grille de direction est la suivante :
Après quelques essais, j'ai fixé trois niveaux de proximité :
Nearà 100 mm ou moinsFarentre 100 et 250 mmClearau-delà de 250 mm
Associer les modules ToF et afficheur LCD
Le système applique une règle de propriété simple afin de séparer les responsabilités de chaque tâche et de pouvoir ajouter facilement de nouveaux sous-systèmes, comme des servomoteurs :
| Tâche | Rôle | Propriété exclusive |
|---|---|---|
Brain_thread | Résoudre le comportement | BehaviorController |
Sensors_thread | Effectuer les mesures | VL53L5CX |
Display_thread | Animer et dessiner | LVGL et GC9A01 |
Les échanges passent par des files de messages FreeRTOS : PetEvent relie la tâche de capteurs à Brain_thread, tandis que DisplayCommand transporte les consignes de rendu vers l'écran. La file d'affichage applique une politique « latest value wins » : les commandes plus anciennes sont remplacées, car seule la réaction la plus récente doit être affichée.
Lorsqu'un objet est détecté, le flux est donc le suivant :
Bilan de la phase 1
Cette phase aboutit à une chaîne fonctionnelle reliant mesure et rendu : le capteur ToF publie un changement spatial, Brain_thread choisit un état et une direction, puis la tâche d'affichage anime le visage avec une transition fluide.
Dum-E sait déjà :
- regarder dans huit directions ou revenir au centre
- distinguer une présence lointaine d'une proximité immédiate
- cligner des yeux en mode normal, grâce à une routine continue en l'absence d'événement
- adopter une expression surprise lorsqu'un objet s'approche trop près
- remplacer proprement une animation en cours par la réaction la plus récente
Au-delà des yeux mobiles, l'enjeu est d'établir un modèle de communication fiable entre les tâches. Les moteurs recevront à leur tour des consignes, l'audio produira des événements et l'OTA restera isolée du rendu. La phase 2 ajoutera une contrainte plus physique : faire bouger quatre servomoteurs sans provoquer de brownout, avec des rails d'alimentation séparés et des trajectoires non bloquantes.