Compresser un CNN 1D pour l'Edge AI : mesures, limites et compromis
Quelle qualité de classification peut-on conserver lorsque la taille du modèle et la latence deviennent des contraintes de déploiement ?
Cet article étudie un cas simple de reconnaissance d'activités humaines à partir de signaux inertiels. L'objectif n'est pas de désigner une technique de compression universellement supérieure, mais de mesurer séparément l'effet de trois décisions :
- réduire la capacité du réseau avec une architecture Student
- entraîner ce Student par distillation
- quantifier le modèle après entraînement (PTQ) ou pendant le fine-tuning (QAT)s
Cette distinction est importante : la réduction du nombre de paramètres vient d'abord de l'architecture Student. La distillation améliore son apprentissage sans changer sa taille, tandis que la quantification modifie la représentation numérique des poids et de certaines activations.
Données et tâche de classification
Le cas d'étude utilise le jeu de données UCI Human Activity Recognition Using Smartphones. Il regroupe les mesures de 30 personnes portant un smartphone à la taille. Les capteurs ont été échantillonnés à 50 Hz, puis les signaux ont été découpés en fenêtres de 128 échantillons — soit 2,56 s — avec un recouvrement de 50 %.
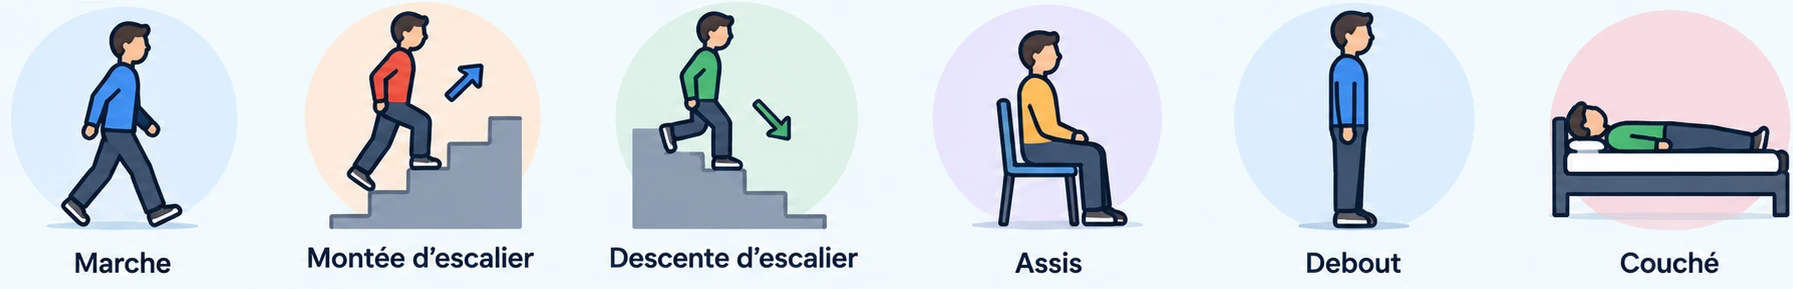
Parmi les signaux inertiels fournis par le jeu de données, ce projet utilise six canaux : les trois axes de l'accélération corporelle estimée et les trois axes de la vitesse angulaire. Chaque fenêtre est associée à l'une des six activités :
- marche
- montée d'escalier
- descente d'escalier
- position assise
- position debout
- position couchée
Pourquoi un CNN 1D pour un signal IMU ?
Une fenêtre IMU est une série temporelle courte et multicanal. Le tenseur d'entrée
suit ici l'ordre (batch, channels, time), soit (B, 6, 128). Une convolution
1D peut apprendre des motifs temporels locaux : oscillation de la marche,
transition, impact d'un pas ou relation entre accélération et rotation.
Un filtre de convolution utilise les mêmes poids sur toute la fenêtre temporelle. Il peut donc détecter un même motif, par exemple l'impact d'un pas, quelle que soit sa position dans la fenêtre, sans apprendre des poids différents pour chaque instant. Contrairement à un réseau récurrent, un CNN peut traiter plusieurs positions de la fenêtre en parallèle. Enfin, le nombre limité de couches et de filtres permet ici de construire un modèle Student compact de 5462 paramètres.
Un LSTM pourrait être pertinent si la dépendance temporelle à modéliser dépassait la fenêtre courante. Un Transformer deviendrait intéressant pour des séquences plus longues ou lorsque les relations à longue portée justifient le coût de l'attention. Le CNN 1D n'est donc pas un choix universel : il correspond ici à une fenêtre courte, une fréquence fixe et une cible CPU contrainte.
Protocole expérimental
Le jeu de test officiel contient 2 947 fenêtres. Le jeu d'entraînement est séparé en sous-ensembles d'apprentissage et de validation par sujet : une même personne ne doit pas apparaître dans les deux ensembles. Cette précaution évite une fuite de données entre fenêtres fortement corrélées, notamment parce que les fenêtres successives se recouvrent à 50 %.
Les statistiques de normalisation appliquées à la validation et au test sont calculées uniquement sur le sous-ensemble d'apprentissage. Les mêmes paramètres sont ensuite utilisés dans les pipelines Python et C++.
Le benchmark d'inférence utilise :
- une entrée fixe de forme
(1, 6, 128) - 100 inférences de chauffe
- 2 000 inférences mesurées
- un nouveau processus pour chaque modèle
ORT_SEQUENTIALet un seul thread intra-opORT_ENABLE_ALLdans les deux implémentations- le temps de chargement du modèle exclu
- la moyenne et les percentiles p50, p95 et p99 enregistrés séparément
Les mesures ont été réalisées sous Windows sur un AMD Ryzen 5 5600
(6 cœurs, 12 threads), avec Python 3.11 et le CPUExecutionProvider d'ONNX
Runtime. Les numéros de version exacts doivent être reportés depuis
l'environnement ayant produit les résultats (pip freeze et version de la
bibliothèque C++), afin que le benchmark soit reproductible.
Ce protocole mesure une latence steady state sur un cœur logique. Il n'inclut ni le démarrage à froid, ni l'acquisition IMU, ni le fenêtrage, ni la normalisation. L'utilisation répétée d'une entrée de même taille réduit aussi la variabilité et favorise les caches, les résultats ne constituent donc pas une mesure de latence de bout en bout.
Trois familles de techniques
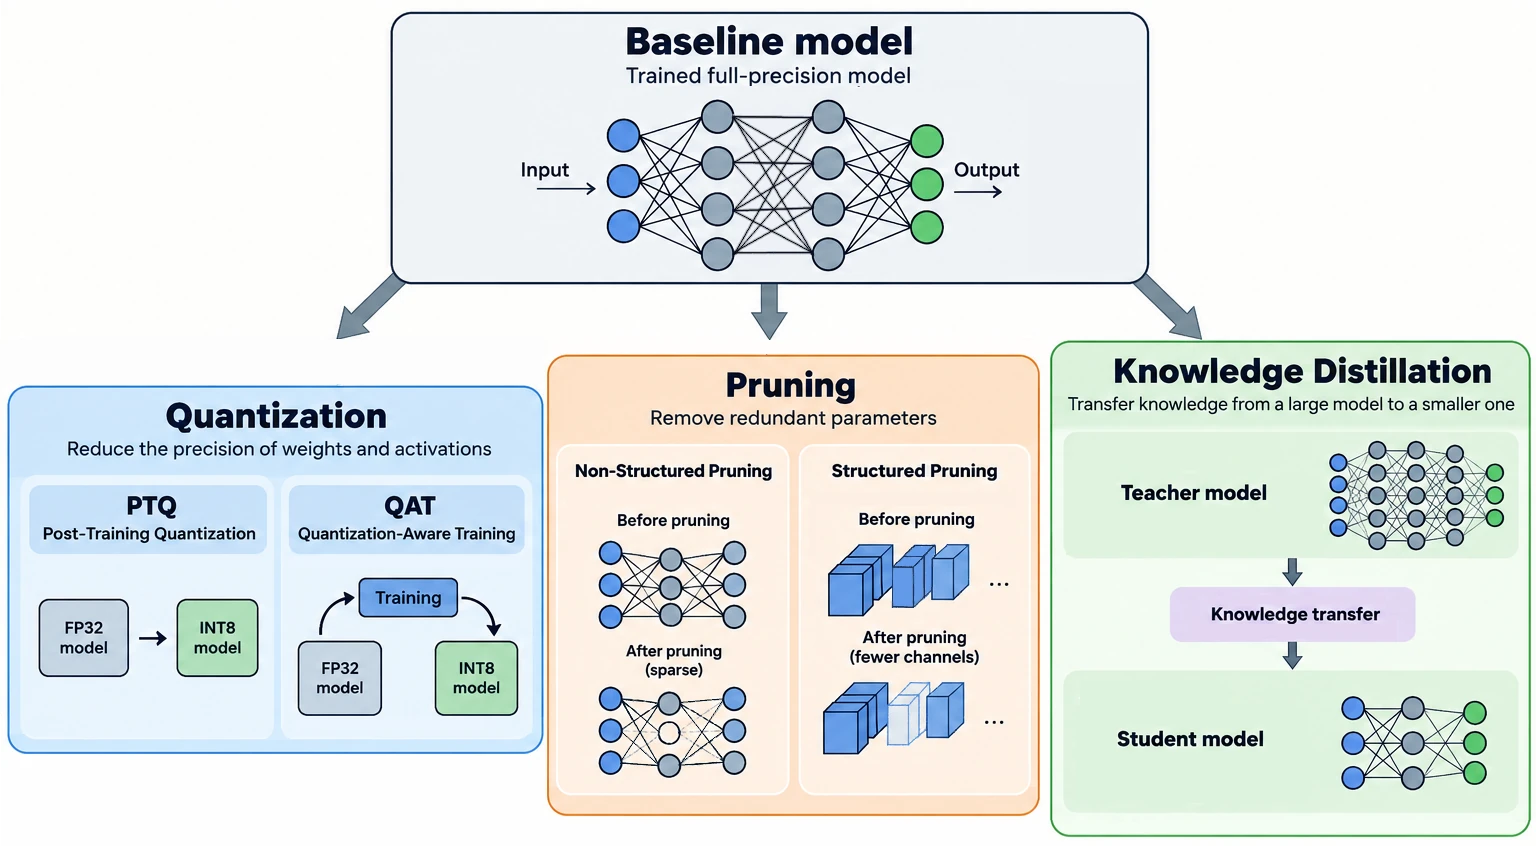 Vue d'ensemble de la quantification, de l'élagage et de la distillation
La figure présente trois familles courantes. Cet article mesure la distillation et la quantification. L'élagage (pruning) est présenté pour situer le sujet, mais n'est pas inclus dans les résultats.
- Le pruning non structuré met à zéro des poids individuels. Il produit de la parcimonie, mais ne réduit pas automatiquement la latence ou la taille du fichier sans stockage creux et noyaux adaptés.
- Le pruning structuré retire des unités complètes — par exemple des canaux ou des filtres — et peut donc modifier réellement les dimensions du réseau. Il est généralement plus simple à exploiter sur du matériel généraliste, au risque d'une perte de qualité plus marquée à taux de pruning égal.
Distillation : apprendre plus qu'un label
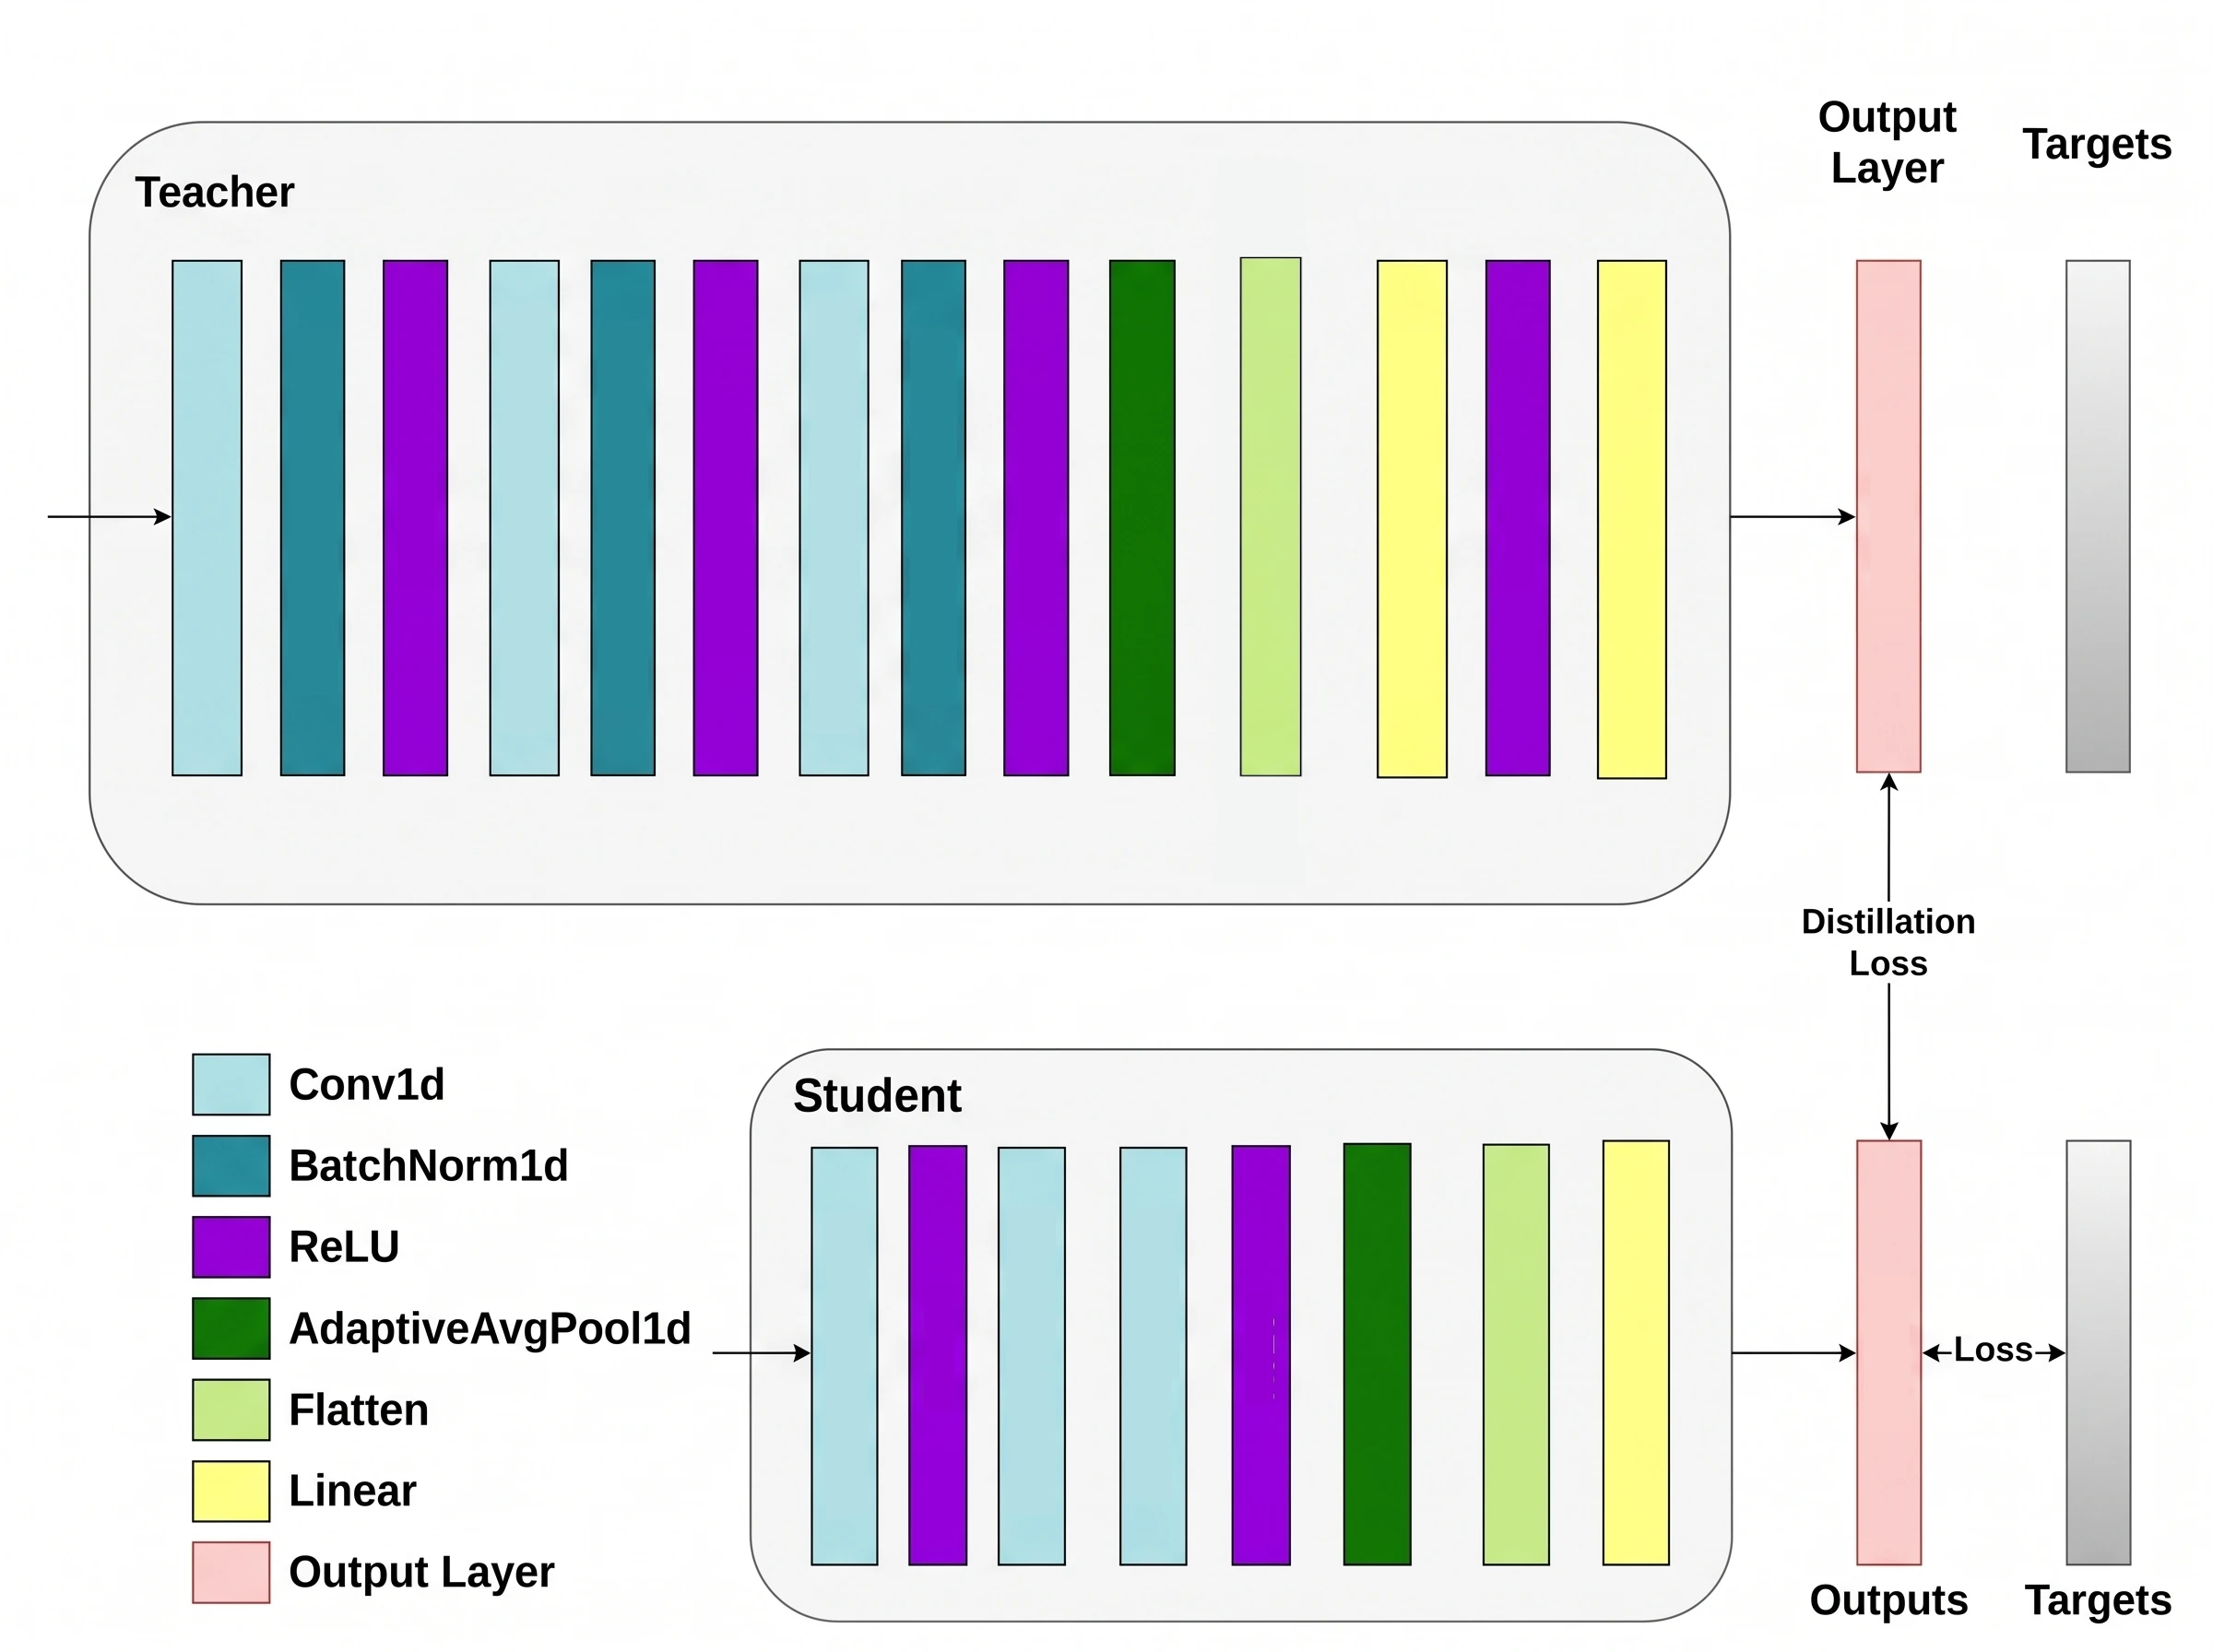 Architecture du Teacher et du Student
Le Student de référence apprend avec une entropie croisée classique. Pour une
fenêtre de marche, la cible indique seulement que WALKING est la bonne classe.
Elle n'exprime pas que WALKING_UPSTAIRS est une confusion plus plausible que
LAYING.
La distillation ajoute la distribution de sortie du Teacher comme signal d'apprentissage. La fonction de coût utilisée est :
où et sont les logits du Teacher et du Student, la température et le poids donné à la distillation. Ici, est la cross-entropy avec le label dur , calculée sur les logits du Student à température 1. Le terme KL compare les distributions adoucies du Teacher et du Student à la même température . Le facteur compense le changement d'échelle des gradients introduit par la température.
L'architecture et les 5 462 paramètres du Student restent inchangés. La distillation ne compresse donc pas directement ce réseau : elle aide un modèle déjà compact à mieux utiliser sa capacité. Le Teacher n'est nécessaire que pendant l'entraînement.
Post-Training Quantization (PTQ)
Dans cette étude, la Post-Training Quantization est appliquée après
l'apprentissage. Un ensemble de 1 024 fenêtres représentatives du jeu
d'entraînement sert à calibrer les plages d'activation. Les poids sont quantifiés
par canal et le modèle ONNX est représenté sous forme QDQ
(QuantizeLinear/DequantizeLinear).
Une plage de calibration trop étroite sature les valeurs extrêmes. Une plage trop large augmente le pas de quantification et réduit la résolution disponible pour les petites variations. Le jeu de calibration doit donc couvrir les différents sujets, activités, amplitudes, pics et niveaux de bruit attendus en production.
La PTQ ne demande pas de réentraînement. En revanche, un graphe QDQ n'implique pas que tous les opérateurs s'exécutent en entier 8 bits : cela dépend des opérateurs, des noyaux disponibles et de l'Execution Provider. Les entrées et sorties peuvent également rester en FP32 autour de régions quantifiées.
Quantization-Aware Training (QAT)
Le QAT part du Student distillé et simule les effets de la quantification pendant un fine-tuning. Dans cette configuration, les activations utilisent une quantification simulée en UINT8 et les poids des convolutions et de la couche linéaire une quantification simulée en INT8, avec une échelle par canal de sortie.
Pendant le passage avant, la fake quantization reproduit l'arrondi, la saturation et la déquantification tout en conservant des tenseurs flottants pour l'entraînement. La rétropropagation permet alors aux poids de s'adapter à ces erreurs numériques. Le QAT demande une phase d'entraînement supplémentaire, mais il conserve souvent mieux la qualité lorsque la PTQ ne respecte pas le budget d'erreur visé.
Pipeline d'apprentissage et de déploiement
Résultats
Le Teacher FP32 atteint un F1-score de 0,90 avec 176 966 paramètres. Le Student de référence, limité à 5 462 paramètres, obtient 0,69. Il contient 32,4 fois moins de paramètres, mais cette réduction d'architecture est aussi la principale source de perte de qualité.
La distillation porte le même Student à 0,76 de F1-score, sans modifier son architecture. La PTQ atteint 0,72. Le QAT obtient 0,74 : dans cette expérience, il récupère presque tout le F1 du Student distillé tout en produisant le plus petit fichier.
Tableau de synthèse
| Variante | Représentation | Paramètres | Taille ONNX | p95 Python / C++ | F1-score |
|---|---|---|---|---|---|
| Teacher CNN 1D | FP32 | 176 966 | 689,9 Kio | 514,6 / 528,0 µs | 0,90 |
| Student de référence | FP32 | 5 462 | 23,1 Kio | 82,5 / 42,2 µs | 0,69 |
| Student distillé | FP32 | 5 462 | 23,1 Kio | 65,0 / 50,2 µs | 0,76 |
| Student distillé PTQ | QDQ, U8/S8 | 5 462 | 15,3 Kio | 64,0 / 42,8 µs | 0,72 |
| Student distillé QAT | QDQ, U8/S8 | 5 462 | 10,9 Kio | 63,4 / 45,7 µs | 0,75 |
La taille du fichier QAT est environ 63 fois inférieure à celle du Teacher. Cette comparaison additionne toutefois deux effets : le changement d'architecture entre Teacher et Student, puis la quantification. Pour isoler le gain de la quantification, il faut comparer le QAT au Student distillé FP32 : le fichier passe alors de 23,1 à 10,9 Kio, soit une réduction d'environ 2,1 fois.
Compromis qualité–latence
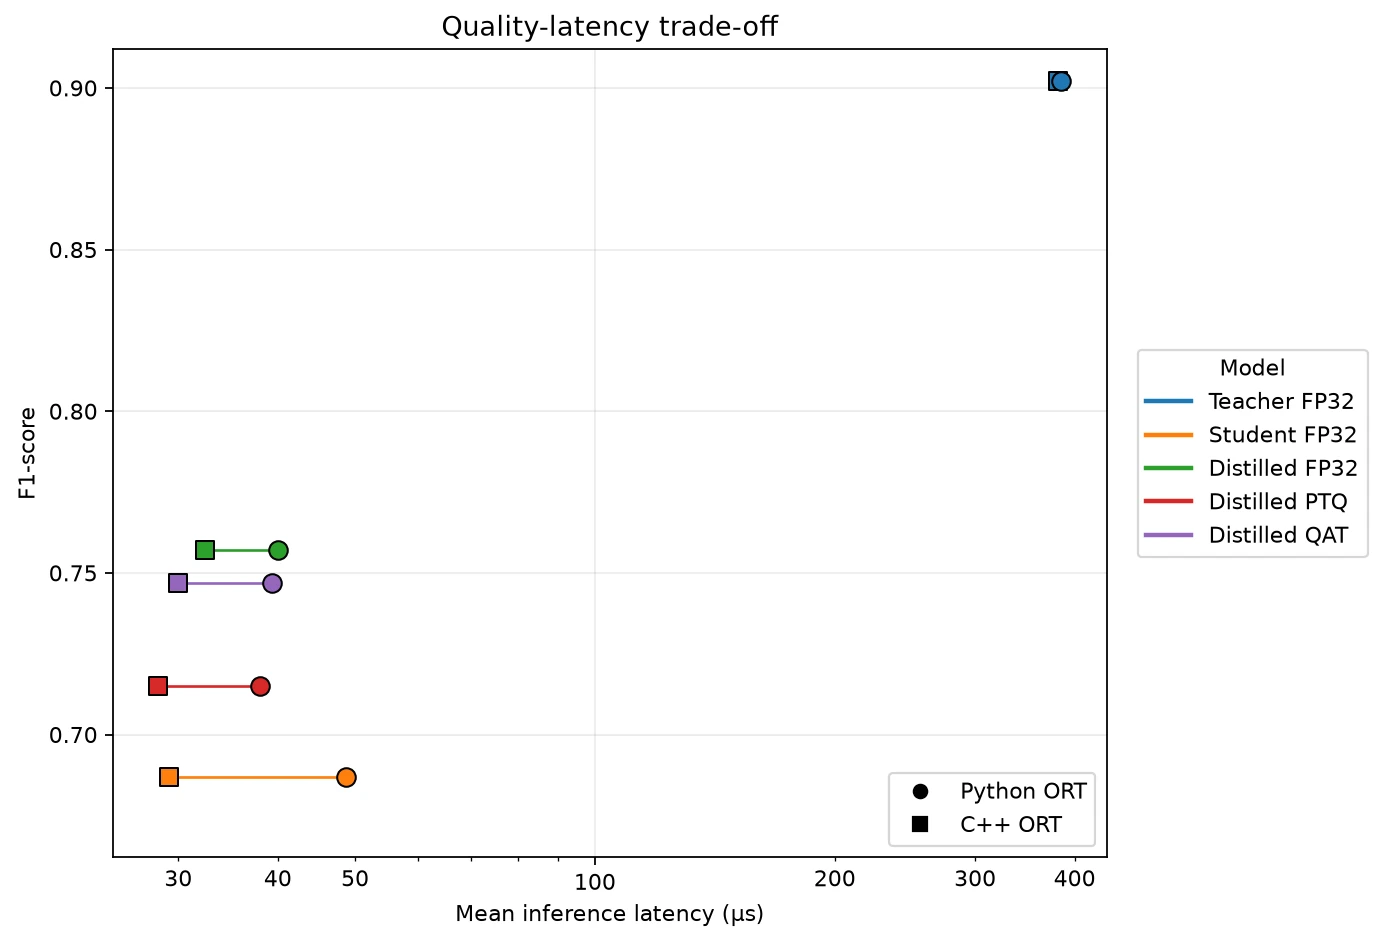 F1-score en fonction de la latence moyenne
Le Teacher occupe une zone distincte : son F1-score est nettement supérieur, mais sa latence est aussi plus élevée. Parmi les petits modèles, le Student distillé FP32 conserve le meilleur F1-score. Le QAT se place légèrement en dessous en qualité, avec le plus petit fichier. Les segments colorés relient les mesures Python et C++ d'un même fichier ONNX. Les cercles représentent Python et les carrés C++.
La quantification n'accélère pas automatiquement ce petit réseau sur le Ryzen 5 5600. Le coût des transitions Q/DQ, la disponibilité des noyaux, les surcoûts fixes du runtime et la très petite quantité de calcul peuvent masquer le bénéfice de l'INT8. Le principal gain de latence provient ici du passage du Teacher au Student.
Limites de l'étude
Cette expérience repose sur une seule graine aléatoire, un seul découpage de validation et une seule machine. Elle ne fournit ni intervalle de confiance, ni distribution sur plusieurs entraînements, ni mesure de consommation énergétique.
Le benchmark ne mesure que le runtime ONNX sur une entrée déjà préparée. Un déploiement Edge AI complet devrait aussi mesurer :
- l'acquisition, le fenêtrage et la normalisation
- le pic de RAM, et pas seulement la taille du fichier (RSS)
- le temps de démarrage et la première inférence
- la latence sous charge et la consommation énergétique
- la matrice de confusion, notamment entre
SITTINGetSTANDING - la robustesse à de nouveaux sujets, placements de capteur et niveaux de bruit
Une étude plus complète répéterait l'apprentissage avec plusieurs graines, utiliserait plusieurs découpages par sujet et rapporterait moyenne, écart-type ou intervalle de confiance.
Conclusion
Les résultats conduisent aux observations suivantes :
- l'architecture Student contient 32,4 fois moins de paramètres que le Teacher, mais perd une part importante de sa qualité
- la distillation récupère 7,0 points de F1 score sans ajouter de paramètres
- la PTQ est simple à appliquer, mais dégrade ici le Student distillé
- le QAT conserve 98,7 % du F1 du Student distillé et réduit son fichier d'un facteur d'environ 2,1
Le Student distillé FP32 reste le meilleur choix parmi les petits modèles si le F1-score est prioritaire. Le QAT est préférable lorsque le stockage est plus contraint et qu'une baisse de 0,01 de F1 score est acceptable. Sur une cible embarquée réelle, la décision finale doit être reprise avec les noyaux, la mémoire et le budget énergétique de cette cible : un benchmark x86 ne suffit pas à prédire le comportement d'un microcontrôleur ou d'un accélérateur.